如果你最近在检索技术资料、翻阅大模型源码或者调试一个效果始终上不去的推荐模型,大概率会反复撞见"注意力机制"这四个字。它既是当下深度学习领域最核心的构件之一,也是很多工程师从"能调包"迈向"能改结构"的分水岭。本文尝试把注意力机制讲透:它为什么被发明出来、内在的数学直觉是什么、Transformer注意力机制具体怎么搭、工程上如何优化,以及它在信息检索、强化学习、无人机仿真等场景中的实际落点。
一、注意力机制为什么会出现:先解决信息瓶颈
在注意力机制流行之前,序列到序列任务(比如机器翻译)主要靠循环神经网络加编码器—解码器结构。这类结构有个天然缺陷:无论输入句子多长,编码器最后都要把它压缩成一个固定长度的向量,再交给解码器使用。
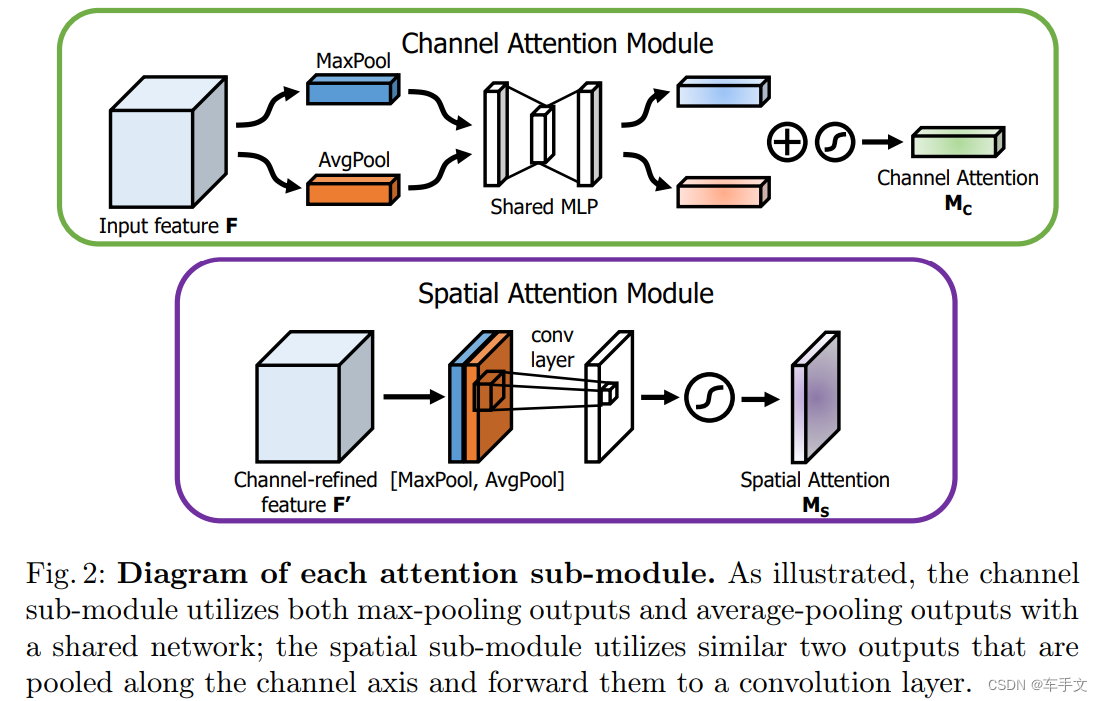
短句子还好,一旦遇到长段落,这个向量就成了瓶颈——前面的信息被反复覆盖,模型"记不住"开头说了什么。这就像一个团队把所有项目资料强行塞进一页纸的摘要里,细节必然丢失。
注意力机制的思路非常直白:既然压缩会丢信息,那就不要压缩。解码器在生成每一个词的时候,直接回头去看编码器的全部输出,并按照相关性给它们分配不同权重。相关性高的部分权重高,也就是被"注意"得更多。这套思路让长距离依赖问题得到明显缓解,也让后续的Transformer架构有了立足点。
二、核心原理拆解:Query、Key、Value 三件套
现代注意力机制几乎都建立在查询(Query)、键(Key)、值(Value)这套类比之上。可以用图书馆检索来理解:
- Query(查询):你心里想找的主题,比如"注意力机制如何加速推理"。
- Key(键):每本书书脊上的标签,用来和你的需求做匹配。
- Value(值):书的实际内容,只有被匹配上的书才会被翻阅。
计算过程分三步走。第一步,用 Query 和每一个 Key 做相似度计算,常见做法是点积,得到一组分数。第二步,把分数除以维度的平方根做缩放,再经过 Softmax 归一化成概率分布。除以平方根这一步很关键:维度较大时点积结果容易过大,Softmax 会退化成近似 one-hot,梯度几乎消失。第三步,用归一化后的权重对所有的 Value 加权求和,得到最终输出向量。
一句话概括:注意力机制本质上是一种可学习的、动态的加权聚合操作。它的参数不是固定的,而是随输入内容实时变化,这正是它比固定卷积核更灵活的地方。
三、自注意力与多头注意力:Transformer 的骨架
当 Query、Key、Value 全部来自同一个序列时,就叫自注意力(Self-Attention)。序列中的每个位置都能直接和其余所有位置交互,任意两个词之间的路径长度都是常数级,这让它在建模长距离依赖时天然占优。
多头注意力:让模型同时看多个角度
单次注意力只能学到一种关联模式。多头注意力把 Q、K、V 投影到多组低维子空间,各自独立计算注意力,再把结果拼接后线性变换。不同头可以分别关注语法结构、指代关系、位置邻近性等不同侧面,类似卷积网络中多个卷积核提取不同特征。
位置编码:补上顺序信息
自注意力本身是置换不变的——把输入打乱,输出也跟着打乱,顺序信息并不会自动保留。所以必须显式注入位置编码。早期Transformer注意力机制采用正弦余弦函数生成绝对位置编码,后来更多模型转向可学习位置嵌入、相对位置编码或旋转位置编码(RoPE),后者在长文本场景下外推表现更好。
与 RNN、CNN 的对比
- 对比 RNN:RNN 必须按时间步串行计算,难以并行;注意力可以一次性矩阵运算完成,训练效率高得多。
- 对比 CNN:卷积的感受野随层数线性增长,注意力则是一层内全局可见。
- 代价:计算复杂度随序列长度呈平方增长,这也是长上下文场景最大的成本来源。
四、注意力家族图谱:常见变体与取舍
为了在效果和成本之间取得平衡,研究者衍生出了大量变体,工程中常见的包括:
- 交叉注意力(Cross-Attention):Query 来自解码端,Key 与 Value 来自编码端,广泛用于翻译、图文对齐、语音识别。
- 稀疏注意力:只让每个位置关注局部窗口或若干全局节点,把复杂度压到接近线性。
- 线性注意力:通过核函数近似重构计算顺序,先算 Key 与 Value 的乘积,降低显存占用。
- FlashAttention:不改变数学结果,而是借助分块计算和显存层级优化,显著降低显存读写开销。
- 分组查询注意力(GQA/MQA):多个查询头共享同一组键值头,推理时大幅减少 KV Cache 占用,是目前大模型部署的主流选择。
选型没有银弹。短序列任务用标准多头注意力通常足够;长文档理解、检索增强场景则要认真评估稀疏化或线性化方案,否则显存和延迟会迅速失控。
五、注意力机制在真实业务中的落点
1. 信息检索与推荐
传统信息检索技术依赖倒排索引和 BM25 等词频统计方法,优点是快,缺点是难以理解语义。引入注意力后,查询与文档可以做细粒度的语义匹配:查询中的每个词与文档中的每个词计算相关性权重,再聚合为整体打分。这一思路催生了稠密检索、多向量检索以及重排序模型,成为搜索系统和内容推荐系统的常规组件。
2. 文本、语音与多模态
从文本分类、抽取式摘要,到语音识别、图文匹配、视频理解,注意力几乎成了标配模块。它让模型在生成某个输出时,能够明确指认自己"看了哪里",这种可解释性在内容审核、医疗辅助等场景中很有价值。
3. 强化学习与智能决策
在强化学习中,注意力常被用于处理部分可观测环境:智能体面对多源观测(雷达、相机、状态日志)时,用注意力动态决定哪些信息更值得参考。结合元学习算法,还能让策略在任务分布变化时快速调整注意力权重,提升小样本下的泛化能力。决策序列本身也可以用 Transformer 建模,把轨迹视为序列做离线策略学习。
4. 无人机仿真与自动驾驶
这类场景对多传感器融合要求很高。基于 AirSim 仿真搭建的无人机仿真平台,通常会同时输出视觉图像、深度图、惯性测量和位置信息。通过交叉注意力把不同模态的特征对齐融合,可以让感知模块在某一传感器失效或受干扰时依然保持鲁棒。仿真环境的另一个好处是能低成本生成大量带标注的极端工况数据,用于验证注意力模块在真实部署前的稳定性。
六、从理论到代码:一条务实的深度学习入门路径
注意力机制看起来公式不少,但动手实现一遍,理解成本会大幅下降。建议按下面的顺序推进:
- 打牢计算机科学基础:线性代数中的矩阵乘法、Softmax 的数值稳定性、链式求导,这三块吃透了,看论文基本没有障碍。
- 选一门体系化课程起步:偏好自顶向下、先跑通再深挖的,可以跟着 Fast.ai教程 的节奏,从可运行代码切入,逐步回填理论;偏好自底向上推导的,则可配合公开课按章节推进。
- 手写一个最小注意力模块:用 PyTorch 实现缩放点积注意力,打印注意力权重矩阵,观察不同输入下权重的分布变化。这是最直观的验证方式。
- 复现一个微型 Transformer:两三层编码器、一个小型翻译或文本分类数据集,跑通训练与推理全流程。
- 做一次消融实验:去掉位置编码、把多头改成单头、把层数减半,观察指标变化,建立对结构设计的直觉。
这条路径不需要昂贵硬件,单卡甚至免费算力就够跑通。真正的门槛不在算力,而在是否愿意把每一步都亲手验证。
七、工程落地:效果之外的现实约束
在实验室跑出指标是一回事,在生产环境稳定提供服务是另一回事。注意力模型的部署通常要面对以下问题:
- 显存与带宽:推理阶段瓶颈往往不在算力,而在 KV Cache 的读写。采用分组查询注意力、量化键值缓存、分页显存管理都是常见手段。
- 延迟与吞吐:批处理能提升吞吐但拉高单次延迟,需要根据业务对首字延迟的敏感度做取舍。
- 推理加速:算子融合、图优化、INT8 量化、专用推理引擎,通常能带来数倍提升。
- 成本控制:在云计算环境中按需扩缩容,把长上下文任务和短请求分流到不同规格实例,比统一配置更经济。
- 安全与合规:涉及用户数据的检索与推荐系统,需要在数据脱敏、访问控制、日志审计上做配套设计,模型能力再强也不能绕过这条线。
这些工作往往需要软件开发、系统集成与持续运维能力的配合,单靠算法团队难以闭环。对于多数企业来说,与其从零搭建,不如把工程侧交给有信息技术服务经验的团队,让业务侧专注于数据和场景。
八、几个常见误区
- 误区一:注意力权重高就等于因果重要。权重反映的是当前层的相对关注度,多层堆叠后不能简单当作解释结论。
- 误区二:层数越多越好。层数增加会带来过拟合、训练不稳定和推理成本上升,多数任务存在明显边际递减。
- 误区三:注意力能解决所有长依赖。它在超长序列上仍会稀释,配合检索、记忆模块或分段处理往往更实际。
- 误区四:直接上大模型最省事。小数据集上,一个结构合理的轻量模型常常比大模型微调效果更稳、成本更低。
九、写在最后
注意力机制的价值,不在于它有多复杂,而在于它用一套相当简洁的加权聚合逻辑,同时解决了信息瓶颈、并行计算和长距离依赖三个难题。从最初用于机器翻译的辅助模块,到今天支撑起大语言模型、多模态系统、检索排序和智能决策的底层结构,它的演进路径本身就是一段典型的工程史:先有明确的问题,再有克制的方案,最后靠大量细节优化走向可用。
对个人而言,理解注意力的最佳方式始终是动手——写一遍、调一遍、测一遍,比读十篇综述都管用。对企业而言,真正的挑战则在于把模型能力稳定地接入现有业务系统,让算法、数据、算力与运维形成闭环。这两件事,前者靠耐心,后者靠体系。