如果你最近在学深度学习,或者正在用 Fast.ai 教程入门,大概率会被"注意力机制"这个词反复包围。它既是 Transformer 架构的灵魂,也是当下大模型、信息检索、强化学习甚至无人机仿真平台中频繁出现的关键技术。本文从计算机科学基础出发,把注意力机制的原理、变体、工程实践和学习路径讲清楚,帮助你把这块知识真正用起来。
注意力机制到底是什么:一次"有选择的关注"
注意力机制(Attention Mechanism)的核心思想非常朴素:在处理大量信息时,不要平均用力,而是根据当前任务的需要,动态地给不同部分分配不同的权重。用信息传输与软件技术的视角看,它本质上是一种信息筛选与加权聚合的计算范式——输入是一组信息向量,输出是这些向量的加权组合,而权重由"查询"与"键"的匹配程度决定。
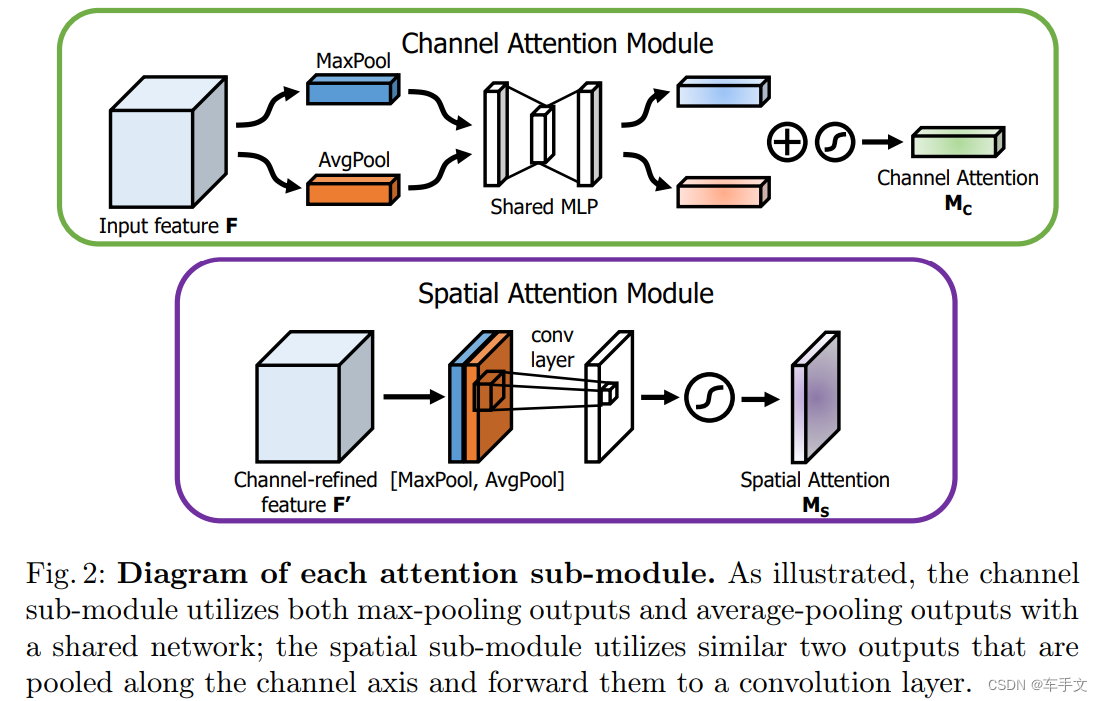
在传统的序列模型(如 RNN、LSTM)中,信息被压缩进一个固定长度的隐状态,长序列容易丢失细节。注意力机制打破了这一瓶颈,让模型可以直接"回看"输入的任意位置。这一改动看似简单,却带来了三个直接收益:
- 长距离依赖建模能力增强:任意两个位置之间只需一步计算即可建立联系;
- 并行计算友好:不依赖时序递归,天然适合 GPU 加速;
- 可解释性提升:注意力权重矩阵可以可视化,帮助分析模型关注了哪些输入片段。
对从事软件开发、系统集成和信息技术服务的技术团队而言,理解这一点很关键:注意力机制不是玄学,而是一种可以拆解、可以调参、可以工程化的计算结构。
从 Q、K、V 说起:缩放点积注意力的计算逻辑
Transformer 注意力机制中最经典的实现是缩放点积注意力(Scaled Dot-Product Attention)。它把输入映射为三组向量:查询(Query)、键(Key)、值(Value)。计算过程可以概括为四步:
- 用查询与所有键做点积,得到相关性分数;
- 除以维度的平方根进行缩放,避免点积过大导致 softmax 梯度消失;
- 经 softmax 归一化为概率分布,即注意力权重;
- 用权重对值向量加权求和,得到输出。
公式写作 Attention(Q, K, V) = softmax(QKᵀ / √dₖ)V。这个结构之所以成为行业标准,是因为它既表达力强,又能高效映射为矩阵乘法,非常适合在云计算平台和大数据环境下做批量推理。
在此基础上,多头注意力(Multi-Head Attention)把 Q、K、V 投影到多个子空间并行计算,再拼接结果。不同的"头"可以捕捉不同的语义关系——有的关注语法搭配,有的关注指代关系,这与信息检索技术中多路召回、多特征融合的思路高度一致。
Transformer 注意力机制的家族图谱
围绕基础注意力,研究者衍生出一系列变体,理解它们的差异有助于在实际项目中做出合理选型:
- 自注意力(Self-Attention):Q、K、V 来自同一序列,用于建模序列内部关系,是 Transformer 编码器的核心;
- 交叉注意力(Cross-Attention):Q 来自解码器,K、V 来自编码器,常见于机器翻译、图文多模态任务;
- 掩码注意力(Masked Attention):通过上三角掩码屏蔽未来信息,保证自回归生成的因果性;
- 稀疏与局部注意力:只计算部分位置对,降低长序列的显存与算力开销;
- 线性注意力与 FlashAttention:从算法与硬件层面优化复杂度,是当前大模型训练的重要工程手段。
在无人机仿真平台 AirSim 这类场景中,注意力机制常被用于多传感器信息融合——把视觉、激光雷达、惯性数据视为不同模态的"值",让模型根据任务动态加权,从而提升感知鲁棒性。这类跨领域应用,正是信息传输与人工智能技术服务融合的典型体现。
注意力机制与元学习、强化学习的结合
注意力机制的价值不止于自然语言处理。在元学习算法中,注意力可以用来快速适配新任务:模型通过注意力对少量支持样本加权,实现"学会学习"的快速泛化。在强化学习中,注意力帮助智能体在复杂状态空间中聚焦关键观测,例如在仿真环境中识别障碍物或目标区域,显著提升策略学习的样本效率。
对于做平台开发、大数据分析与智能运维的团队来说,这意味着注意力机制可以作为通用组件嵌入到推荐系统、异常检测、日志分析等多种业务中,而不局限于文本任务。
工程落地:学习路径与实战建议
想把注意力机制真正掌握,建议按以下路径推进,避免陷入"只看公式不动手"的误区:
- 打牢计算机科学基础:线性代数中的矩阵乘法、概率中的 softmax、微积分中的梯度传播,是理解注意力的三块基石;
- 跟一遍 Fast.ai 教程:自上而下的教学方式能让你先跑通模型,再回头理解细节,适合深度学习入门者;
- 手写一个最小注意力模块:用 PyTorch 实现单头注意力,打印权重矩阵并可视化,直观感受"关注"的含义;
- 做一个小型信息检索实验:用注意力对文档片段加权打分,对比传统 TF-IDF 效果,理解语义匹配的优势;
- 关注推理优化:了解 KV Cache、量化、算子融合等工程技巧,这些直接决定线上服务的延迟与成本。
在系统集成与技术支持的实际项目中,还需要注意数据质量、显存预算和部署环境。注意力模型的性能表现高度依赖输入表示的质量,做好数据清洗与特征工程,往往比盲目堆叠层数更有效。
常见误区与选型提醒
最后提醒几个容易踩坑的地方。其一,注意力权重高不等于因果贡献大,可视化结果需要谨慎解读;其二,注意力并非万能,在小规模结构化数据上,梯度提升树等传统方法可能更划算;其三,长序列场景下标准注意力的平方复杂度会带来成本压力,应优先评估稀疏或线性方案。技术选型应始终围绕业务目标,而非追逐热点。
注意力机制从提出到成为深度学习的基础设施,走过了十余年。它连接了信息检索、自然语言处理、强化学习与仿真系统等多个方向,也正在云计算与人工智能服务平台中发挥越来越重要的作用。把原理吃透、把代码跑通、把场景想清楚,才是掌握这项技术最稳妥的方式。