在当今人工智能飞速发展的时代,注意力机制(Attention Mechanism)已经成为深度学习领域最具革命性的技术之一。从自然语言处理到计算机视觉,从语音识别到强化学习,注意力机制正在重塑我们对神经网络架构的认知。创智数据科技长期关注信息传输与人工智能技术的前沿发展,本文将系统性地剖析注意力机制的核心原理、技术演进与实战应用,为深度学习入门者和进阶开发者提供一份兼具理论深度与实践价值的参考指南。
一、注意力机制的本质:让模型学会“选择性关注”
注意力机制的核心思想并不复杂:在面对大量信息时,人类不会平均分配注意力,而是会有选择地聚焦于当前任务最相关的部分。深度学习中的注意力机制正是对这一认知过程的数学建模。它允许模型在处理输入序列时,动态地为不同位置的信息分配不同的权重,从而更有效地捕捉关键特征。
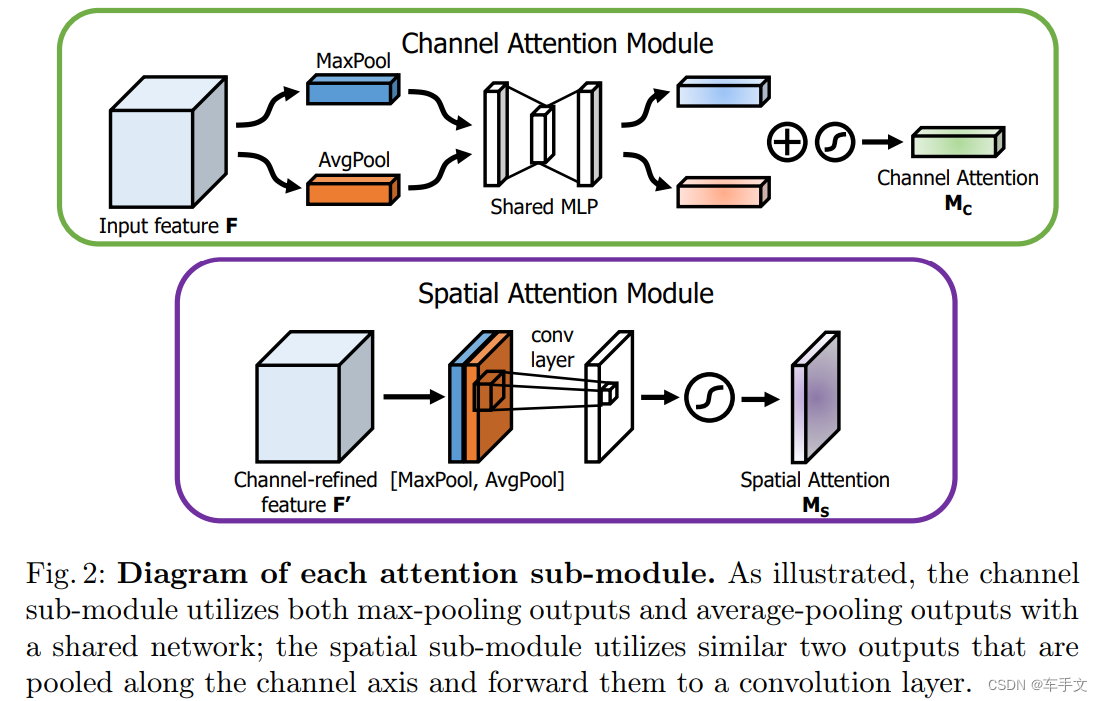
从技术实现角度看,注意力机制通常涉及三个核心要素:查询(Query)、键(Key)和值(Value)。模型通过计算Query与各个Key之间的相似度得分,经过归一化处理后得到注意力权重,再对Value进行加权求和,最终输出聚焦后的信息表示。这一过程可以用一个简洁的公式表达:Attention(Q, K, V) = softmax(QK^T / √d_k) · V,其中d_k为键向量的维度,用于缩放点积以防止梯度消失。
这种设计的美妙之处在于,它打破了传统循环神经网络(RNN)逐步处理的序列依赖限制,使模型能够直接建模任意两个位置之间的依赖关系,无论它们相距多远。这为后续Transformer架构的诞生奠定了理论基础。
二、Transformer注意力机制:架构革命的核心引擎
2017年,Google团队发表的论文《Attention Is All You Need》正式提出了Transformer架构,彻底改变了序列建模的技术格局。Transformer完全摒弃了RNN和CNN的循环与卷积结构,纯粹依靠注意力机制来完成信息建模,这一大胆的设计在机器翻译任务上取得了当时的最优性能。
2.1 自注意力与多头注意力
Transformer的核心组件是自注意力机制(Self-Attention)。在自注意力中,Query、Key和Value均来自同一个输入序列,模型通过计算序列内部各位置之间的注意力权重,捕捉上下文中的长距离依赖关系。例如,在处理句子“无人机在复杂环境中飞行时保持稳定”时,自注意力机制能够让“稳定”一词直接关注到“无人机”和“飞行”,而无需像RNN那样逐步传递信息。
在此基础上,多头注意力(Multi-Head Attention)进一步将注意力计算扩展到多个子空间。每个“头”独立计算一组注意力权重,最终将多个头的输出拼接后线性变换。这种设计使模型能够同时从不同表示子空间中捕捉多样化的语义关系,极大地增强了表达能力。在信息检索技术中,多头注意力已被广泛用于建模查询与文档之间的多粒度相关性。
2.2 位置编码与残差连接
由于Transformer不含循环结构,模型无法天然感知序列中元素的顺序信息。为此,Transformer引入了位置编码(Positional Encoding),通过正弦函数或可学习嵌入为每个位置生成独特的编码向量,与词嵌入相加后输入模型。此外,残差连接与层归一化的组合有效缓解了深层网络的训练困难,使Transformer能够稳定地堆叠数十层甚至上百层。
三、注意力机制的多元变体与技术演进
随着研究的深入,注意力机制衍生出了多种变体,以适应不同场景的需求:
- 缩放点积注意力:Transformer的基础形式,通过缩放因子控制点积的数值范围,保证softmax梯度的稳定性。
- 加性注意力:通过前馈网络计算Query与Key的兼容性,适用于维度不一致的场景。
- 交叉注意力:Query来自一个序列,Key和Value来自另一个序列,常用于编码器-解码器架构中,实现输入与输出之间的信息对齐。
- 稀疏注意力与局部注意力:针对长序列场景,通过限制注意力范围或引入稀疏模式降低计算复杂度,在长文本处理和大规模信息检索中尤为重要。
- 线性注意力:通过核函数近似将注意力计算复杂度从O(n²)降至O(n),为超长序列建模提供了可行方案。
这些变体共同构成了注意力机制丰富的技术生态,也为深度学习入门者理解不同架构的取舍提供了绝佳的学习路径。在Fast.ai教程等实践课程中,注意力机制的变体实现往往是进阶学习的重点内容。
四、注意力机制与元学习算法的协同创新
元学习算法(Meta-Learning)旨在让模型“学会学习”,即通过少量样本快速适应新任务。注意力机制在元学习中扮演着重要角色:它可以帮助元学习器在任务分布中动态关注最相关的历史经验,从而提升少样本场景下的泛化能力。
具体而言,基于注意力的元学习架构通常包含两个层次:外层元学习器负责从多个任务中提取共性知识,内层注意力模块则根据当前任务的少量支持样本,动态调整特征表示的关注重点。这种协同机制在图像分类、自然语言推理等少样本任务中表现出色,也为信息传输与智能服务领域的个性化推荐、异常检测等应用提供了新的技术思路。在无人机仿真平台的研究中,注意力增强的元学习算法同样展现出快速适应不同飞行环境的潜力。
五、注意力机制在行业中的典型应用场景
5.1 自然语言处理与信息检索
在信息检索技术中,注意力机制被用于构建查询-文档匹配模型。通过交叉注意力计算查询词与文档片段之间的语义相关性,系统能够超越传统关键词匹配的局限,实现更精准的语义搜索。搜索引擎、智能客服和知识库问答系统均受益于此。
5.2 计算机视觉与仿真平台
视觉Transformer(ViT)将注意力机制引入图像分类任务,通过将图像切分为patch序列并应用自注意力,取得了与卷积网络相当甚至更优的性能。在AirSim仿真与无人机仿真平台中,注意力机制被用于多传感器融合与目标跟踪,帮助无人机在复杂环境中实现精准感知与决策。
5.3 强化学习与智能决策
在强化学习领域,注意力机制能够帮助智能体从高维观测中提取关键状态信息,提升策略学习的效率与稳定性。结合计算机科学基础中的概率图模型与序列决策理论,注意力增强的强化学习算法在机器人控制、自动驾驶和游戏博弈等场景中展现出强大的应用前景。
六、从理论到实践:学习注意力机制的建议路径
对于希望系统掌握注意力机制的开发者,建议遵循以下学习路径:
- 夯实计算机科学基础:熟练掌握线性代数、概率论与微积分,理解矩阵运算与梯度下降的基本原理。
- 深度学习入门:从神经网络基础、反向传播和优化算法入手,逐步过渡到序列模型与注意力机制。
- 动手实现Transformer:借助PyTorch或TensorFlow从零实现多头注意力模块,通过Fast.ai教程等资源进行项目驱动学习。
- 结合行业场景实践:在信息检索、无人机仿真或强化学习等具体任务中应用注意力机制,积累调参经验与工程直觉。
创智数据科技在软件开发、系统集成与人工智能技术服务方面积累了丰富经验,深知理论知识与工程实践之间的鸿沟。注意力机制的学习不应止步于公式推导,更需要在真实数据与业务场景中反复验证和优化。
七、结语
注意力机制从最初的一个辅助模块,发展为如今深度学习架构的核心引擎,其演进历程折射出人工智能领域“化繁为简、聚焦本质”的技术哲学。无论是Transformer注意力机制在自然语言处理中的统治地位,还是其在信息检索、元学习算法和无人机仿真平台中的广泛渗透,都说明了一个事实:理解注意力机制,是打开现代深度学习大门的关键钥匙。对于信息传输与信息技术服务行业的从业者而言,掌握这一技术不仅有助于提升系统智能化水平,更能在数字化转型的浪潮中占据技术先机。