在深度学习快速迭代的今天,注意力机制(Attention Mechanism)已经成为支撑众多前沿模型的核心构件。无论是自然语言处理中的Transformer架构,还是计算机视觉中的图像识别,抑或是强化学习中的决策优化,注意力机制都扮演着不可替代的角色。本文将从注意力机制的基本原理出发,结合信息传输、软件开发和人工智能技术服务等行业的实际应用场景,系统梳理这一技术的演进脉络与落地路径,为从事深度学习入门、信息检索技术研究以及无人机仿真平台开发的工程师提供一份可参考的技术地图。
注意力机制的本质:让模型学会"选择性关注"
注意力机制的核心思想并不复杂:在处理大量信息时,模型不应平等对待每一个输入,而应根据当前任务的需要,动态分配关注权重。这一思路借鉴了人类认知系统的特点——我们在阅读一段文字或观察一幅图像时,注意力会自然聚焦于关键部分,而忽略次要信息。
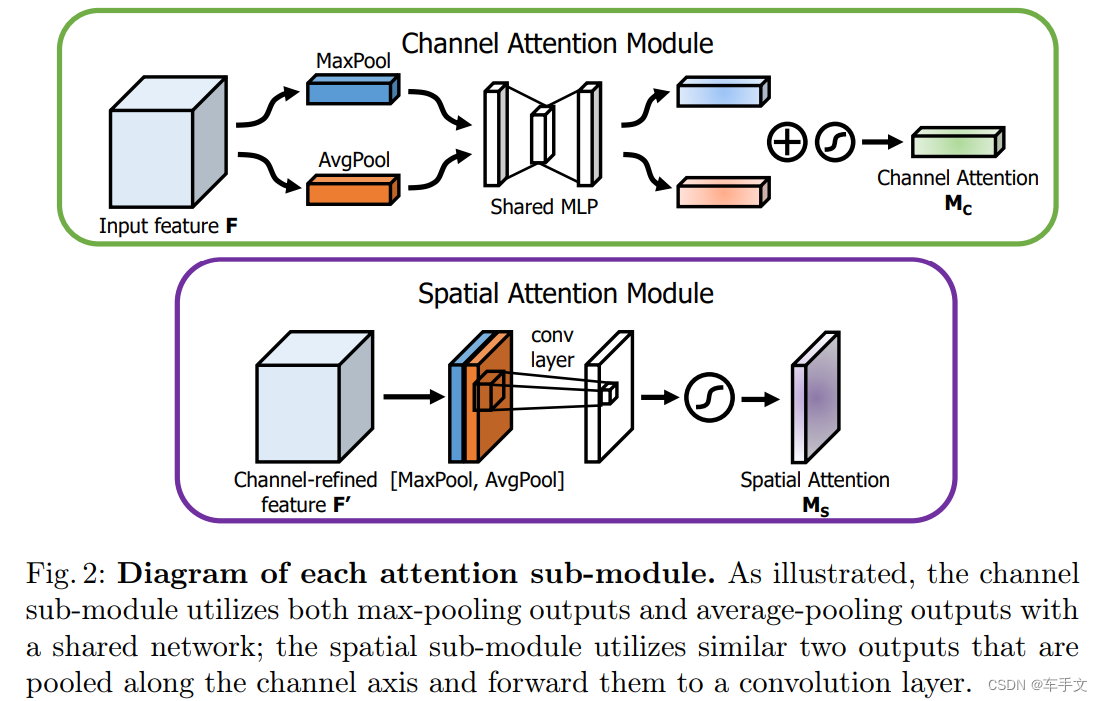
从技术实现角度看,注意力机制通常包含三个要素:查询(Query)、键(Key)和值(Value)。模型通过计算查询与各个键之间的相似度,得到一组权重分布,再用这些权重对值进行加权求和,从而输出聚焦后的表示。这种"软寻址"的方式,使得模型能够在海量信息中高效提取与当前任务最相关的内容。
- 自注意力(Self-Attention):查询、键、值均来自同一序列,用于捕捉序列内部的长距离依赖关系。
- 交叉注意力(Cross-Attention):查询来自一个序列,键和值来自另一个序列,常用于编码器-解码器架构中的信息对齐。
- 多头注意力(Multi-Head Attention):将注意力计算并行化多组,每组关注不同的子空间特征,最终拼接输出,增强模型的表达能力。
在信息传输与互联网技术服务领域,注意力机制被广泛用于日志分析、用户行为建模和网络安全威胁检测。例如,在系统运维场景中,通过对海量日志序列施加注意力权重,运维平台可以自动聚焦于异常模式,显著降低误报率。
Transformer注意力机制:架构革新与工程实践
2017年提出的Transformer架构,将注意力机制推向了舞台中央。与传统的循环神经网络(RNN)和卷积神经网络(CNN)不同,Transformer完全依赖注意力机制来建模序列关系,摒弃了循环结构,从而实现了高度并行化的训练方式。这一架构革新直接催生了BERT、GPT系列等大规模预训练模型,深刻改变了自然语言处理的技术格局。
Transformer注意力机制的关键设计包括缩放点积注意力、位置编码和多层堆叠。缩放点积注意力通过除以维度的平方根来稳定梯度;位置编码则弥补了注意力机制本身不具备顺序感知能力的缺陷;多层堆叠使得模型能够逐层抽象出更复杂的语义特征。
在实际工程落地中,Transformer注意力机制的应用远不止于文本处理。在软件开发与系统集成行业,开发团队利用Transformer对API调用链进行建模,实现故障根因的自动定位;在云计算平台的资源调度中,注意力机制帮助系统预测负载峰值,优化弹性伸缩策略。对于正在学习Fast.ai教程或计算机科学基础课程的开发者而言,理解Transformer注意力机制的数学推导与代码实现,是迈向高阶深度学习应用的关键一步。
注意力机制与元学习算法的协同
元学习算法(Meta-Learning)旨在让模型"学会学习",即通过少量样本快速适应新任务。注意力机制与元学习算法的结合,产生了诸多有价值的研究方向。例如,在少样本分类任务中,模型可以利用注意力机制对支持集样本进行加权聚合,从而更准确地构建类别原型;在强化学习场景中,注意力机制帮助智能体在复杂环境中聚焦于关键状态特征,加速策略收敛。
这种协同效应在无人机仿真平台与AirSim仿真环境中体现得尤为明显。无人机在动态环境中执行任务时,需要实时处理来自多传感器的信息流。通过引入注意力机制,仿真系统能够对视觉、雷达和惯性数据进行自适应融合,提升感知精度;而元学习算法则使无人机在面对新场景时,能够基于少量交互数据快速调整飞行策略。对于从事强化学习与无人机仿真平台开发的团队来说,这一技术组合提供了从仿真训练到真实部署的可行路径。
信息检索技术中的注意力应用
信息检索技术是注意力机制最早取得突破的应用领域之一。传统检索模型依赖词频统计和倒排索引,难以捕捉查询与文档之间的语义关联。引入注意力机制后,检索系统可以对查询词和文档片段进行细粒度的语义匹配,显著提升检索相关性。
具体而言,基于注意力机制的信息检索技术通常采用双塔结构或交互式匹配结构。双塔结构分别编码查询和文档,通过注意力池化生成固定维度的向量表示,适合大规模召回场景;交互式匹配结构则让查询与文档在词级别进行交叉注意力计算,适合精排阶段。在互联网信息服务、大数据平台和企业知识管理系统中,这类技术已被广泛应用于搜索引擎优化、智能客服和文档推荐等业务。
- 语义召回:利用注意力池化生成查询与文档的稠密向量,突破关键词匹配的局限。
- 相关性排序:通过交叉注意力建模查询-文档的词级交互,提升排序精度。
- 多模态检索:将注意力机制扩展至图文跨模态场景,支持以图搜文、以文搜图等应用。
从仿真到落地:注意力机制的工程化建议
对于希望将注意力机制引入实际项目的技术团队,以下几点工程经验值得参考。首先,注意力机制并非万能钥匙,在数据规模较小或任务结构简单的场景中,传统方法可能更具性价比。其次,注意力权重的可解释性是一把双刃剑——它既能为模型决策提供可视化依据,也可能因权重分布过于分散而难以解读。再次,在部署阶段需要关注注意力计算的内存开销,尤其是在长序列场景下,稀疏注意力和线性注意力等变体值得评估。
在无人机仿真平台与AirSim仿真的实践中,建议团队先在仿真环境中验证注意力模块的有效性,再逐步迁移至真实设备。仿真平台提供了可控的实验条件和丰富的传感器数据,是验证Transformer注意力机制与元学习算法协同效果的理想沙盒。同时,结合Fast.ai教程中的实践方法,开发者可以快速搭建原型并进行迭代验证,缩短从概念到产品的周期。
结语
注意力机制从最初的一个辅助模块,发展为今天深度学习架构的核心支柱,其演进历程折射出人工智能技术从"暴力计算"走向"智能聚焦"的深层逻辑。对于信息传输、软件开发与人工智能技术服务行业的从业者而言,深入理解注意力机制的原理与工程实践,不仅有助于把握Transformer、元学习、信息检索和强化学习等方向的技术脉络,更能为无人机仿真平台等复杂系统的开发提供坚实的方法论支撑。创智数据科技将持续关注这一领域的技术进展,为开发者社区提供更多有价值的技术内容与实践参考。