在深度学习与人工智能的浪潮中,注意力机制(Attention Mechanism)已经成为绕不开的核心概念。从2017年Transformer架构横空出世,到如今大语言模型、计算机视觉、强化学习乃至无人机仿真平台的广泛应用,注意力机制几乎重塑了信息传输与软件技术服务的底层逻辑。本文将从计算机科学基础出发,结合信息检索技术、元学习算法、Fast.ai教程与AirSim仿真等实践场景,系统梳理注意力机制的原理、演进与落地路径,帮助开发者和技术团队建立完整的认知框架。
一、注意力机制的本质:让模型学会“有所取舍”
传统神经网络在处理序列信息时,往往对所有输入一视同仁,导致关键信息被淹没、计算资源被浪费。注意力机制的核心思想,是让模型根据当前任务动态分配权重——重要的信息给予更高关注,无关的信息则被抑制。这种“加权聚焦”的能力,正是人类认知过程的数学化表达。
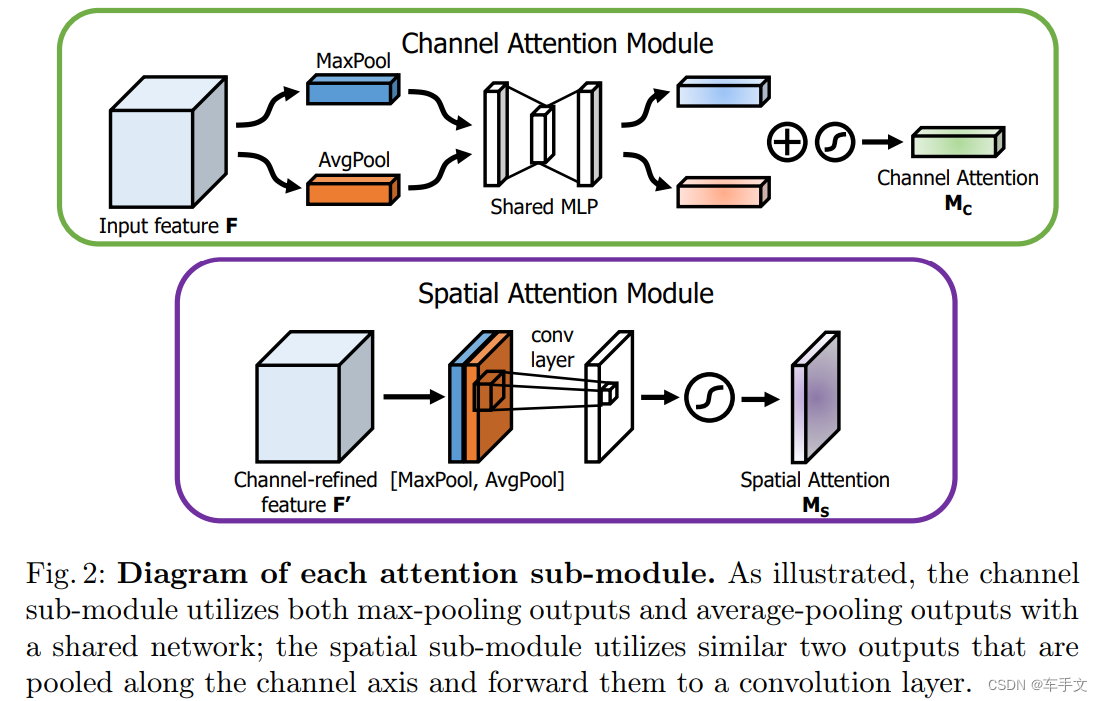
从计算机科学基础的角度看,注意力机制可以理解为一个软寻址过程:查询向量(Query)与键向量(Key)计算相似度,得到注意力权重,再对值向量(Value)加权求和。其公式表达为:
- 相似度计算:通过点积、加性模型或余弦相似度衡量Query与Key的匹配程度;
- 权重归一化:使用Softmax函数将得分转化为概率分布,保证权重之和为1;
- 加权聚合:以权重对Value进行加权求和,输出上下文向量。
这一套流程看似简单,却解决了长距离依赖建模的难题。在信息传输与信息技术服务领域,注意力机制让系统能够从海量日志、文本、传感器数据中精准提取关键信号,为后续的软件开发、系统集成与智能运维提供可靠支撑。
二、Transformer注意力机制:并行化带来的范式革命
Transformer注意力机制的最大贡献,在于彻底摆脱了循环神经网络(RNN)的串行结构。通过自注意力(Self-Attention)与多头注意力(Multi-Head Attention),模型可以并行处理整个序列,并同时捕捉不同子空间中的语义关系。
1. 自注意力与多头机制
自注意力让序列中的每个位置都能与其他所有位置交互,从而建立全局依赖。多头注意力则将输入映射到多个子空间,各自独立计算注意力后再拼接,相当于让模型从多个“视角”观察同一段信息。这种设计在自然语言处理、信息检索技术中表现尤为突出——例如在搜索引擎的语义匹配环节,多头注意力能够同时关注词级、短语级和句级的相关性。
2. 位置编码与长文本建模
由于自注意力本身不具备顺序感知能力,位置编码(Positional Encoding)成为必要补充。绝对位置编码、相对位置编码以及旋转位置编码(RoPE)的演进,直接推动了大模型上下文窗口的扩展。对于从事平台开发、大数据处理的技术团队而言,理解位置编码的取舍,是优化长文本检索与文档理解系统的关键。
3. 计算复杂度与工程优化
标准自注意力的计算复杂度随序列长度呈平方级增长,这在处理超长日志、卫星传输数据或大规模知识库时构成瓶颈。为此,稀疏注意力、线性注意力、FlashAttention等工程优化方案相继出现。在云计算与人工智能服务场景中,合理选择注意力变体,往往能在精度与推理成本之间取得平衡。
三、注意力机制与元学习算法的协同
元学习算法(Meta-Learning)关注“学会学习”,即让模型在少量样本下快速适应新任务。注意力机制在元学习中扮演着双重角色:一方面作为任务编码器,将不同任务的特征映射为注意力权重;另一方面作为记忆读取器,从外部记忆中检索与当前任务相关的知识。
- 任务感知注意力:在模型无关元学习(MAML)等框架中,注意力网络可根据任务描述动态调整初始化参数;
- 记忆增强网络:通过注意力读写外部记忆矩阵,实现跨任务知识复用,减少灾难性遗忘;
- 少样本分类:在原型网络与关系网络中,注意力用于度量样本与类原型之间的匹配程度。
对于提供系统集成与技术支持服务的企业来说,元学习加注意力的组合意味着更低的定制成本——同一套模型可以快速适配不同客户的业务场景,从电信计费到广播电视内容审核,都能通过少量标注数据完成迁移。
四、信息检索技术中的注意力应用
信息检索技术是注意力机制最早落地的领域之一。从传统的BM25到基于神经网络的稠密检索,注意力机制贯穿了查询理解、文档表示与相关性排序的全流程。
在查询端,注意力机制可以识别用户意图中的核心词与修饰词,抑制噪声词干扰;在文档端,段落级与句子级注意力能够突出与查询最相关的片段,为摘要生成和答案抽取提供依据。结合大数据平台与云计算资源,现代检索系统可以在毫秒级完成亿级文档的语义匹配,这正是信息技术服务行业对高效信息传输的直接需求体现。
此外,在网站建设与内容管理场景中,引入注意力加权的推荐模块,可以显著提升用户点击率与停留时长。技术团队可以借助Fast.ai教程中的实战案例,快速搭建基于注意力的检索原型,再逐步迁移到生产环境。
五、强化学习与无人机仿真平台中的注意力实践
强化学习(Reinforcement Learning)与注意力机制的结合,正在改变智能决策系统的设计方式。在无人机仿真平台AirSim中,智能体需要从高维视觉输入中提取关键环境信息,注意力机制帮助其聚焦于障碍物、目标点和飞行走廊,而非均匀处理整幅图像。
- 视觉注意力:在AirSim仿真环境中,通过注意力模块对深度图与RGB图像进行特征融合,提升避障决策的鲁棒性;
- 时序注意力:在强化学习的轨迹预测中,注意力用于回看历史状态,识别对当前动作最关键的时刻;
- 多智能体协同:注意力机制让多个无人机智能体在通信受限条件下,选择性关注邻居的关键信息,降低带宽压力。
这些实践对信息传输行业具有直接参考价值——卫星传输、应急通信与无人机巡检等场景,都需要在有限带宽下做出高效的信息取舍。通过AirSim仿真平台进行算法验证,再结合深度学习入门知识逐步调优,是技术团队低成本试错的有效路径。
六、从Fast.ai教程到工程落地:学习路径建议
对于希望系统掌握注意力机制的开发者,建议遵循“基础理论—框架实践—场景迁移”的三阶段路径。Fast.ai教程提供了自顶向下的教学方式,让学习者在完成图像分类、文本分类等项目的过程中,自然理解注意力模块的作用。
具体而言,可以先从计算机科学基础中的线性代数与概率论入手,理解点积注意力与Softmax的数学含义;随后在PyTorch或TensorFlow中手写单头与多头注意力,对比不同实现方式的性能差异;最后将注意力模块嵌入信息检索、强化学习或仿真平台的具体任务中,观察其对指标的影响。
需要提醒的是,注意力机制并非万能药。在数据量不足或任务本身缺乏长距离依赖时,过度堆叠注意力层反而会带来过拟合与计算浪费。工程实践中应结合业务特点,通过消融实验验证其必要性。
七、结语:注意力机制是方法,更是思维方式
回顾注意力机制的发展脉络,从Transformer注意力机制的并行革命,到元学习算法中的任务感知,再到信息检索技术与AirSim仿真平台中的落地应用,其价值早已超越单一模型组件。它代表了一种“按需分配计算资源”的工程哲学,这与信息传输、软件和信息技术服务业追求高效、精准、可扩展的目标高度契合。
对于创智数据科技而言,持续跟踪注意力机制的前沿进展,并将其融入软件开发、系统集成与技术支持的服务体系,是保持技术竞争力的重要途径。无论是构建大数据检索平台,还是探索无人机仿真与强化学习方案,理解注意力的本质,都能帮助团队在复杂业务中做出更明智的技术选型。